

很多网站为了不让页面出现在Google,直接在robots.txt里Disallow。结果搜索引擎无法读取页面上的noindex,URL仍可能因为外部链接以无摘要形式出现。
两种工具解决的问题不同:robots.txt是抓取管理,noindex是索引指令。敏感内容更不能依赖它们,而需要登录和权限控制。
01 robots.txt控制爬虫访问路径
它适合减少对后台、内部搜索、无限参数或低价值资源的抓取,但规则是公开的,也不能阻止所有机器人。
被Disallow的URL仍可能从外部链接被发现,只是搜索引擎无法读取页面内容和meta指令。
02 noindex需要页面可被抓取和读取
在HTML meta robots或HTTP响应头中设置noindex,搜索引擎抓取后会将页面排除出索引。
如果同时用robots.txt阻止抓取,搜索引擎可能看不到noindex。正确顺序通常是先允许抓取并处理noindex,确认退出后再评估是否需要限制抓取。
常见页面的处理建议
| 页面类型 | 建议方式 | 说明 |
|---|---|---|
| 登录与账户页面 | noindex + 正常权限 | 不要仅靠robots保护隐私 |
| 测试/预发布环境 | 身份验证或IP限制 | 比公开noindex更安全 |
| 站内搜索结果 | 通常noindex,可视规模管理抓取 | 防止大量薄页进入索引 |
| 筛选参数页 | 按搜索价值决定canonical/noindex/抓取 | 不能一刀切 |
| PDF等非HTML文件 | X-Robots-Tag noindex | meta标签无法应用 |
| 敏感数据 | 登录、授权与服务器安全 | robots和noindex都不是安全措施 |
03 不要用robots.txt隐藏秘密
robots文件任何人都能查看,反而会列出你不想公开的路径。管理员、客户数据、报价后台和测试接口必须依赖认证与权限。
页面已经泄露时,还要移除内容、撤销访问、清理缓存,并根据情况使用搜索移除工具,不能只加一行Disallow。
04 参数页需要结合规模和价值处理
电商、目录和内容站会产生排序、筛选、分页和追踪参数。部分组合可能有独立搜索价值,更多组合则只是重复。
先确定规范URL、内链方式和索引策略,再决定抓取控制。过度屏蔽可能让搜索引擎无法发现重要产品。
05 发布流程要防止noindex遗留
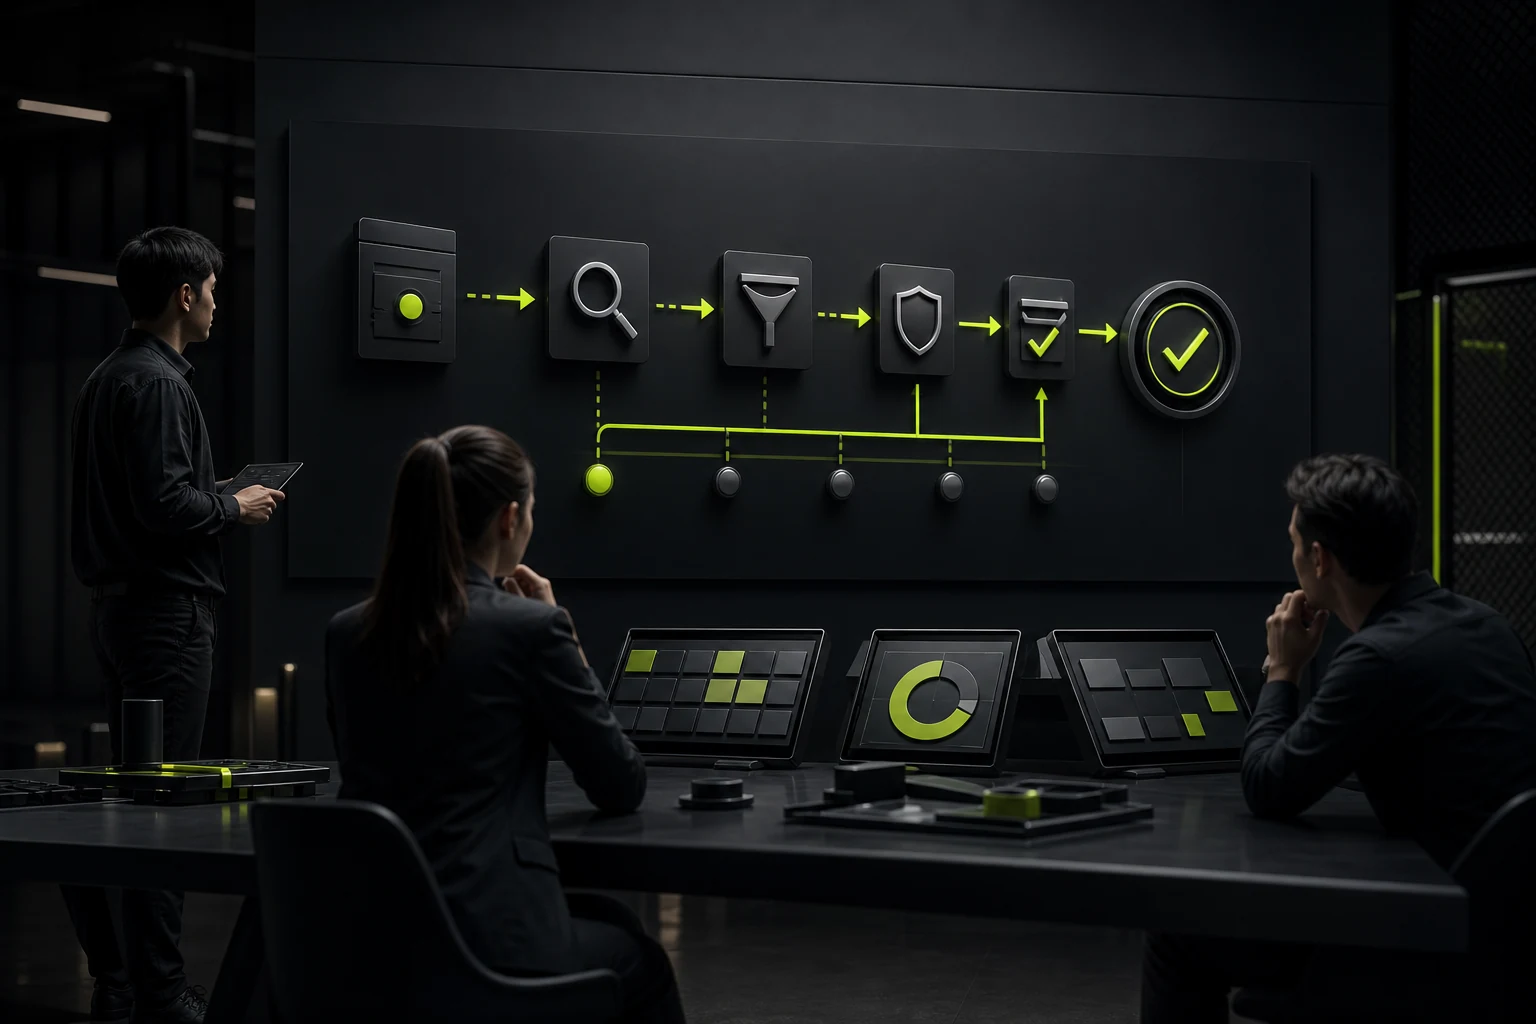
测试环境常用全站noindex,上线时若忘记移除,会让整个网站无法收录。应把检查加入发布流程,并在生产环境自动告警。
反过来,临时页面若被意外索引,也要确认canonical、Sitemap和内部链接是否在持续发送收录信号。
06 修改后用URL检查验证真实结果
查看Google是否能抓取、检测到哪条指令、选择哪个规范URL,并观察索引状态变化。
不要只看源代码。JavaScript注入、缓存、CDN和HTTP头都可能让线上结果与本地不同。
常见问题
robots.txt能让页面从Google删除吗?
不能可靠删除。它阻止抓取,但URL仍可能被发现。要移除索引通常使用noindex并允许抓取。
noindex页面可以放在Sitemap里吗?
不建议。Sitemap应列希望收录的规范URL,noindex表达相反意图。
登录页需要noindex吗?
通常建议,同时必须有真实认证。noindex只影响搜索展示,不提供安全保护。
nofollow和noindex有什么区别?
noindex控制当前页面是否索引;nofollow是对链接跟随或信号的提示,作用对象不同。
页面退出索引后可以再Disallow吗?
可以根据抓取预算评估,但先确认搜索引擎已经看到noindex并移除,避免阻断后续更新。
 链接复制成功








