

重复本身不等于处罚,但会浪费抓取、分散链接和让搜索引擎选择与企业预期不同的版本。规模越大,越需要从URL规则和内容模型治理。
排查时要同时看可访问URL、页面正文、标题、canonical、内链和索引状态。
01 先建立URL清单并按模式分组
从爬虫、日志、sitemap、分析和搜索平台收集URL,识别参数、大小写、斜杠、路径和域名变体。
只抽查几页很难发现系统性生成规则。
02 参数与筛选最容易无限扩张
排序、跟踪、筛选、会话和分页参数可能生成大量近似页面。区分用户功能参数与真正有搜索价值的稳定组合。
控制爬取、内链和索引策略,不要只靠robots掩盖。
03 分类、标签和归档可能重复文章列表
同一文章出现在多个聚合页是正常的,但薄弱标签与年份归档若没有独立价值,应合并或不索引。
聚合页要有明确主题和导航作用。
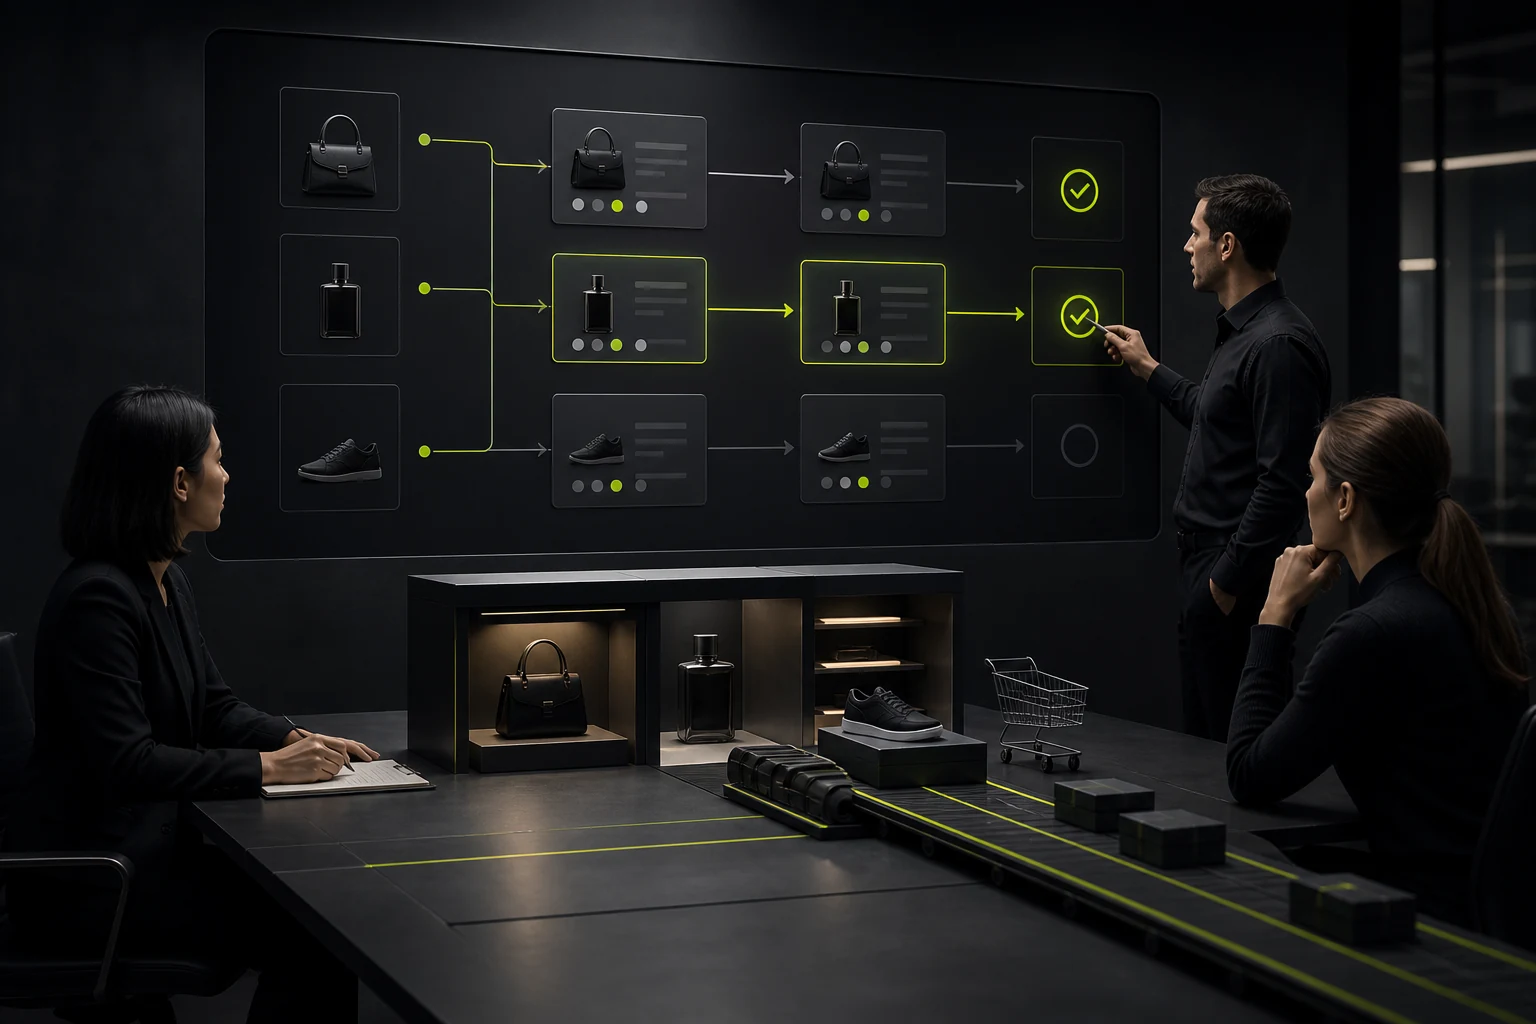
04 产品与多语言内容需要真实差异
仅替换城市、行业或少量词语的页面容易形成低价值重复。多语言版本要使用准确翻译和地区信息。
相似产品可用比较、规格和场景增加独立价值。
05 为每组选择正确处理方式
规范版本使用canonical;永久旧地址使用301;无搜索价值但需用户访问的页面可noindex;完全无用页面删除。
不要把所有问题都交给canonical。
06 内链和网站地图强化最终选择
内部链接、面包屑、hreflang和sitemap只指向规范URL。修复后观察搜索引擎选择的canonical和抓取变化。
新模板上线前测试URL生成。
重复内容处理决策
情况 | 推荐方式 | 注意 |
|---|---|---|
同内容多协议/域名 | 301到规范URL | 同时更新内链 |
跟踪参数 | 规范URL+干净内链 | 保留分析所需参数 |
打印/排序版本 | canonical或noindex | 用户功能仍可用 |
旧文章被新文替代 | 301到相关新文 | 内容必须对应 |
标签页内容薄弱 | 合并/noindex | 不要产生大量空页 |
地区页几乎相同 | 重做独立价值或合并 | 避免机械换地名 |
常见问题
重复内容会被Google处罚吗?
一般不会因为正常重复自动处罚,但可能影响抓取、规范选择和页面表现。
canonical写了就一定会被采用吗?
不一定,它是信号之一,内链、重定向、sitemap和内容也要一致。
robots.txt能解决重复索引吗?
阻止抓取后搜索引擎可能无法看到canonical或noindex,不应作为唯一方案。
分页页面应该全部canonical到第一页吗?
通常不应机械这样做,每页有不同列表内容,应按实际结构设计。
多语言翻译相同算重复吗?
不同语言通常不是普通重复,但应使用正确hreflang和独立可访问URL。
 链接复制成功








